野村:全球机器人ChatGPT时刻即将到来


 收藏
 举报
最近,人形机器人板块持续迎来利好催化,宇树机器人一度20CM涨价,引发市场对机器人才产业的高度关注。
日前,野村给出了一份关于全球机器人的研究报告,报告观点相对冷静也更重要的判断:机器人真正的“ChatGPT时刻”不会由一场发布会宣告,而会由一组运营指标和数据飞轮悄悄确认。
研报将当前机器人技术比作2012年的AlexNet时刻——深度学习已经证明价值,但机器人大脑尚未达到GPT-2水平;12月至1月的新模型可能更接近GPT-2,却仍不具备量产条件。
换句话说,我机器人产业正站在爆发前夜,但爆发不是单点事件,而是一场从模型竞赛转向数据飞轮、硬件一致性和运营验证的耐力赛。
01 从AlexNet到GPT-2:机器人大脑的真实坐标
研报的核心类比是:机器人正在重走大语言模型的老路,只是起点更早。
LLM经历了海量预训练、指令微调和强化学习试错三个阶段,机器人也将如此。英伟达科学家的判断是,机器人训练同样会从广泛学习走向特定任务微调,再通过试错持续提升。
但如今的机器人大脑尚未达到GPT-2阶段:
实验室中已有萌芽,却尚无模型足以胜任实际工作。
通用人工智能公司的1.5模型只需3到12秒演示就能学会任务,十次测试未额外训练成功率59%,仅用五分钟数据补训后升至83%;Skild AI的S1能通过观看人类视频学习冲咖啡;蚂蚁Robbyant的Zero-WAM在七项未见任务中模拟环境成功率47.0%,比同类最佳高29.5个百分点。
这些结果确实呈现出GPT-3式少样本学习的信号,但均来自企业内部测试,任务简短或处于模拟环境,Skild AI首席执行官也直言S1尚未准备进入家庭。
因此,研报仍将机器人大脑定位在GPT-2水平或更低。
真正的突破更可能来自哪里?野村的判断是大型人工智能实验室和特斯拉,而非单纯的机器人大脑初创企业。
实验室拥有算力、人才和通用模型,特斯拉则拥有封闭的数据闭环、工厂测试环境和正在使用的机器人队伍。
谷歌Gemini Robotics 2在2026年7月发布,复杂多步骤任务成功率高达91.3%,全身控制比中国竞争对手领先约一年;
OpenAI预计在12月至1月发布专为物理AI设计的模型,Altman预计2027年能看到OpenAI机器人的“精彩演示”;
王兴兴则透露宇树已在机器人上测试GPT-6,效果非常理想,并认为明年GPT-7有望突破具身AI瓶颈。
催化剂确实密集,但模型发布只是把机器人大脑从GPT-2以下推向GPT-2附近,距离真正爆发仍有距离。
02 三线竞赛:VLA、世界模型与仿真强化学习
机器人大脑的技术路线正在分化为三条:VLA、世界模型和仿真中的强化学习。
VLA观察场景、接收指令并输出动作,通常是下层控制器可以跟随的路径,机载VLA模型约有2到7B参数,需要约3万到4万元人民币的芯片和存储。
世界模型则预测机器人行动后会发生什么?
按照李飞飞的框架,它包含渲染器、模拟器和规划器;World Labs的Atlas达到100到200B参数,生成完整视频的世界模型需要多3到10倍算力,而运行在压缩内部表征上的精简版本只需多30%到100%。
预计到2027年,世界模型将在云端运行,负责训练机器人和生成数据,而紧凑的VLA和RL模型在机器人本体上运行。
仿真强化学习则在物理模拟器内通过试错训练动作,宇树的行走机器人是最著名的例子,仅在仿真中训练的技能已经在真实机器上奏效。
这三条路线并非互斥,而是在竞争成为机器人的“大脑”。
研报提到,早期VLA模型如π0和GROOT将大部分容量花在语言上,因此知道物体是什么,却不知道物体如何运动;WAM改用视频生成作为物理引擎,逐帧预测视频可以教会模型重力、浮力和光,一步预测接下来会发生什么以及机器人应该做什么,从而无需额外训练就能处理新场景。
Dream Dojo研究更进一步,用视频模型替代物理引擎,使机器人能同时在许多模拟世界中练习。
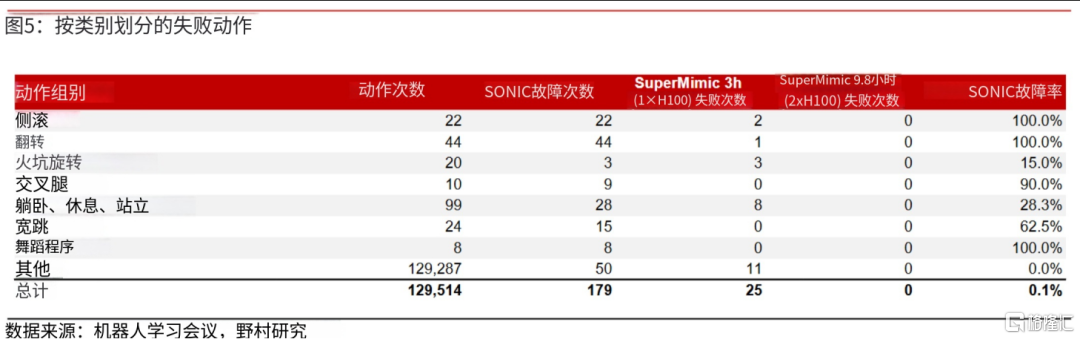
SuperMimic论文则展示了训练方式的变革:仅用一块GPU运行三小时,模型表现就超过了在128块GPU上训练七天的基准模型,计算资源减少1000多倍;在129,514次动作测试中,旧方法失败179次,新模型三小时失败25次,两块GPU运行9.8小时后实现零失败。
这提示我们,应在学习到的模型内而非原始模拟器中训练机器人,并利用更多运动数据训练单一控制器。
但研报也强调,预训练只是整个过程的一半,为了持续改进,模型需要来自实地工作的机器人所产生的数据。
03 数据飞轮:100万小时临界点与视频缩放定律
数据正是制约机器人发展的瓶颈。
语言模型能够利用整个互联网的文本学习,机器人却缺乏类似的数据来源。
遥操作让人类引导机器人采集数据,既昂贵又缓慢,且数据绑定特定机型,一旦机器人从腿式改为轮式便无法再使用。
研报给出的临界点约为100万小时数据,大致相当于一个人的一生所积累的时间;目前以统一格式收集到的可用数据仅约10万小时,领先企业的高质量数据也只有几十万小时,特斯拉Optimus采集的数据刚刚突破50万小时。
启动训练需要1000万小时,长期则需要超过1亿小时,而行业目前仅积累了几百万小时。
更关键的是,大量数据无效:宇树只有约四分之一的记录时间能被利用,每四小时记录中仅一小时有效。
数据采集的市场结构也印证了瓶颈所在。
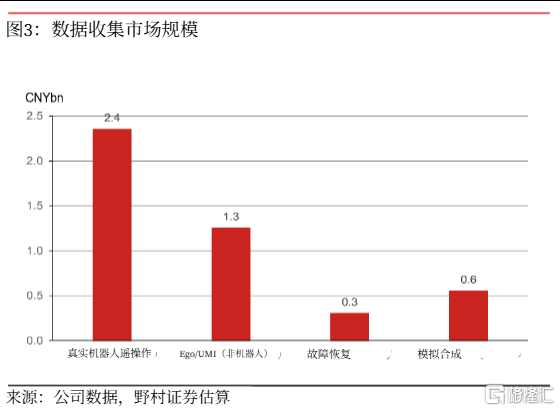
野村估算,2026年中国数据采集市场规模约40亿至50亿元人民币,其中实体机器人遥操作约24亿元,第一人称视频和UMI约13亿元,仿真约6亿元,故障恢复约3亿元。
从成本看,遥操作每小时约700元,UMI约100至300元,第一人称视频约300至350元,仿真约120元。遥操作数据最贵且绑定机型;第一人称视频和UMI成本更低,且视频作为摄像头画面可在不同代次机器人上复用;仿真最便宜,但在真实世界感知任务中的数据占比不超过20%。
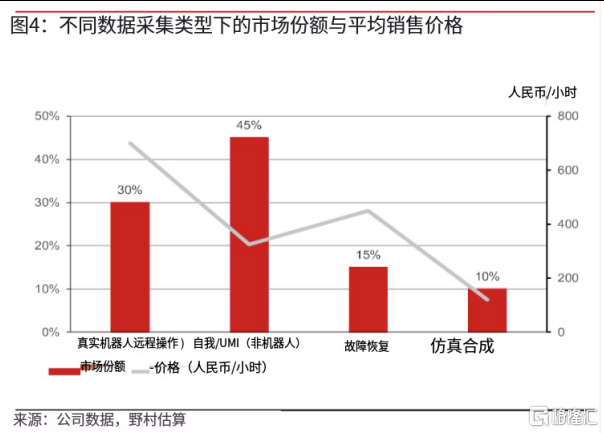
这正是行业转向视频的原因:典型数据构成已是60%第一人称视频、30%UMI、10%真实机器人数据。
英伟达EgoScale先用超过21,000小时日常第一人称视频训练,再用少量遥操作和动作捕捉数据微调;对于手部操控,更多预训练算力能带来稳定且可预测的性能提升,这与推动LLM发展的缩放规律一致。
如果人类视频成为主要数据源,那么谁拥有最佳数据处理流程和最强算力,谁就能获得最大优势。这进一步凸显了大型AI实验室的重要性,也限制了与特定机器人设计绑定的遥操作数据的长期价值。
但真正的ChatGPT时刻在于正向反馈循环开始运转:工作中的机器人生成数据,数据让模型优化,更优秀的模型被更广泛地应用。
特斯拉计划到2026年底通过约1万台自有设施机器人训练,收集100万小时有效数据;2026年第二季度到第三季度,Optimus的数据成本下降了约18.1%。
相比之下,中国部署规模小得多:2026年七家最大快递公司预计采购人形机器人不足500台,2027年也仅约1,000台。
研报因此判断,正向反馈循环会首先在一家公司同时拥有机器人和模型的情况下启动。
OpenAI在2025年9月至2026年8-9月期间购买了约1000万小时数据,占美国供应量约70%;DeepMind采购约20%,相当于OpenAI采购量的三分之一。
独立数据采集商还有大约三年的收集窗口,但随着中国数据无法出口、AI公司依赖自身采集,2027年底数据供应商数量预计减少。
也就是说,数据飞轮的门槛不在“有没有数据”,而在“能否以低成本持续获得有效数据并闭环迭代”。
04 灵巧手与一致性制造:硬件端的iPhone时刻
模型路径确定后,人形机器人设计会逐渐收敛为几种标准化形式,研报称之为硬件领域的“iPhone时刻”。此后最困难的将是如何以统一或相似的方式制造每一台设备。
人形机器人拥有20多个关节,如果不同机器人之间的行为存在细微差异,在一台机器人上训练出的控制策略可能仅适用于少数其他机器人。
因此,最终胜出者将是能快速迭代并严格控制成本的企业,比如宇树科技、汽车制造商以及关键零部件供应商。
量产成本方面,研报估算1.7米高的机器人成本在15万至20万元人民币之间,1.3米高的机器人成本在3万至4万元之间;执行器——电机和齿轮箱组件——占据零部件成本的50%到75%。
宇树目前自研设计覆盖BOM约80%到90%,自研制造约50%左右,第三方模块占10%到15%;随着产量增加,预计它会提高外包比例,既维持低成本也保障质量。
灵巧手将率先受益,因为更强大的AI正在解决阻碍机器人使用复杂夹持器的数据短缺问题。
过去许多机器人采用夹持器,仅仅是因为可用于训练手部的数据太少;更强大的基础模型能够将基于两指或三指夹持器学到的技能迁移到五指手上,从而实现更大抓取能力并降低价格。
野村预计2026年灵巧手出货量将同比增长80%至120%,高自由度技术引领这一趋势;今年将有30%到50%的工厂夹具被取代。
从价格看,连杆、绳驱和直驱等不同技术路线的平均ASP都在下降,但高自由度手部的出货增长更快。硬件端的爆发不是简单的“人手替代夹爪”,而是AI能力提升后,硬件价值从夹持器向灵巧手、执行器和关键零部件转移的过程。
05 五项运营指标:爆发时刻的硬门槛
野村提出了五项测试来判断机器人技术是否进入“ChatGPT时刻”,而目前机器人在所有这些测试中的表现都远不及预期。
第一,机器人在需要人类干预前能持续工作多久:目前表现最好的机器人也只能运行几小时,而工厂要求连续运行一周而不需人工干预。
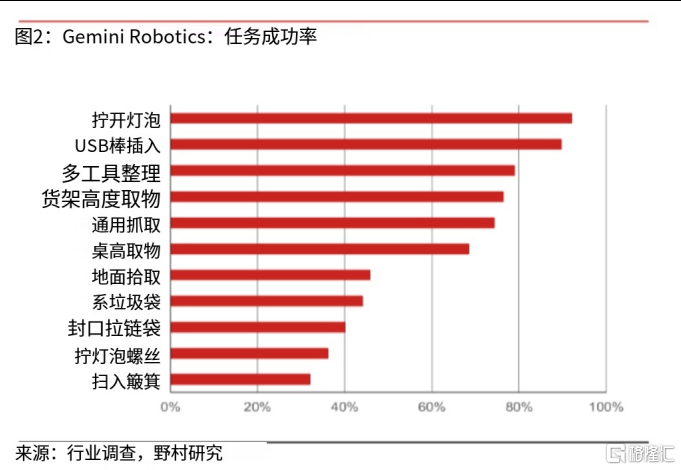
第二,精细手工操作能力:搭载Sharpa Wave手部的Apollo 2机器人——Gemini Robotics 2,能将垃圾袋扎紧的概率仅为44%,将垃圾扫入簸箕的概率仅为32%。
第三,模型适应新机器人机身的速度:谷歌需要大约七到八小时,而中国技术更先进的厂商约需两周。
第四,完成新任务所需的演示次数:实验室环境下已降至一两次。
第五,工厂环境中的操作精度:目前行业检测结果仅为60%左右,而行业要求达到98%以上,野村预计需要三到五年才能缩小这一差距。研报认为第一项与第五项最重要,因为它们决定了客户是否愿意从运营预算而非试验预算中为机器人付费。
这五项指标构成了“真正爆发时刻”的硬门槛。模型发布、演示视频和少样本学习案例可以制造乐观情绪,但只有连续工作一周、工厂精度98%以上、快速适配新机身、低演示次数,才能让机器人从试验预算走进运营预算。
也正因如此,野村将当前定位为“AlexNet时刻”之后、GPT-2之前的加速期,而非ChatGPT时刻本身。真正的爆发时刻,是数据飞轮、模型能力和硬件一致性同时越过临界点的那一刻。
06 结语
机器人行业正在迎来一轮密集的催化剂:OpenAI的物理AI模型、字节跳动和DeepSeek的新模型、OpenAI的人形机器人演示,以及预计2027年推出的GPT-7。
但野村研报的分析显示,这些事件更可能把机器人大脑从GPT-2以下推向GPT-2附近,而不是直接宣告ChatGPT时刻。
真正的爆发时刻需要三个条件同时成立:大型AI实验室或特斯拉式的算力与数据闭环、以视频和世界模型为核心的数据飞轮、以及灵巧手和标准化本体带来的硬件一致性制造。最终胜出者将是那些同时拥有强大计算能力、数据闭环和实地部署机器人的企业。
机器人迎来真正爆发时刻,不是某一天某一款模型突然惊艳世界,而是工作中的机器人开始持续产生有效数据、模型随之优化、更多机器人因此被部署的飞轮悄然启动。
那一刻不会敲锣打鼓,但会在一项项运营指标上留下不可逆的痕迹。


交易商排行
更多
- 监管中Pepperstone 激石10-15年 | 澳大利亚监管 | 塞浦路斯监管 | 英国监管90.40
- 监管中EXNESS10-15年 | 英国监管 | 塞浦路斯监管 | 南非监管88.52
- 监管中FXTM 富拓10-15年 |塞浦路斯监管 | 英国监管 | 毛里求斯监管85.31
- 监管中axi15-20年 | 澳大利亚监管 | 英国监管 | 新西兰监管84.79
- 监管中GRAND MARKETS10年| 澳大利亚监管 | 毛里求斯监管 | 科摩罗昂儒昂监管81.75
- 监管中VSTAR塞浦路斯监管| 直通牌照(STP)80.00
- 监管中GoldenGroup高地集团澳大利亚| 5-10年85.87
- 监管中Moneta Markets亿汇澳大利亚| 2-5年| 零售外汇牌照77.92
- 监管中GTCFX10-15年 | 阿联酋监管 | 毛里求斯监管 | 瓦努阿图监管71.45
- 监管中IC Markets10-15年 | 澳大利亚监管 | 塞浦路斯监管91.96